O autorze
Jakub Stankowski – programista .NET i Angular od 2018 roku. Pracował nad projektami frontendowymi, backendowymi i fullstackowymi, przestrzegając zasad czystego kodu, DRY i stosując CQRS. Ma również doświadczenie jako trener programowania.
Od 2023 roku intensywnie pracuje z Claude AI oraz metodą Spec-Driven Development (SDD) – produkcyjnym workflow do pracy z AI opartym na zasadzie: najpierw specyfikacja, potem implementacja. Na ProgramujZAI.pl dzieli się praktyczną wiedzą o tym, jak programować z AI bez chaosu w kodzie.
Claude Code spec driven development to podejście, w którym najpierw piszesz precyzyjną specyfikację zadania, a dopiero potem uruchamiasz Claude Code do implementacji — zamiast zaczynać od ogólnego promptu i liczyć na to, że model „się domyśli”. W praktyce oznacza to trzy elementy: plik specyfikacji dla konkretnego zadania, dobrze ustrukturyzowany CLAUDE.md jako stały kontekst projektu oraz jasno zdefiniowane kryteria akceptacji, które model musi spełnić, zanim uznasz zadanie za zakończone. Poniżej pokazuję dokładny workflow, którego sam używam, żeby Claude Code przestał „improwizować” i zaczął dowozić kod zgodny z założeniami za pierwszym podejściem.
Najważniejsze informacje:
- Specyfikacja przed promptem — zanim otworzysz Claude Code, zapisz cel, kontekst, ograniczenia i kryteria akceptacji w osobnym pliku.
- CLAUDE.md jako „stała pamięć” projektu — konwencje, architektura i zasady, które model ma respektować w każdej sesji.
- Improwizacja modelu rośnie wprost proporcjonalnie do luk w specyfikacji — im mniej dopowiedzeń, tym mniej domysłów AI.
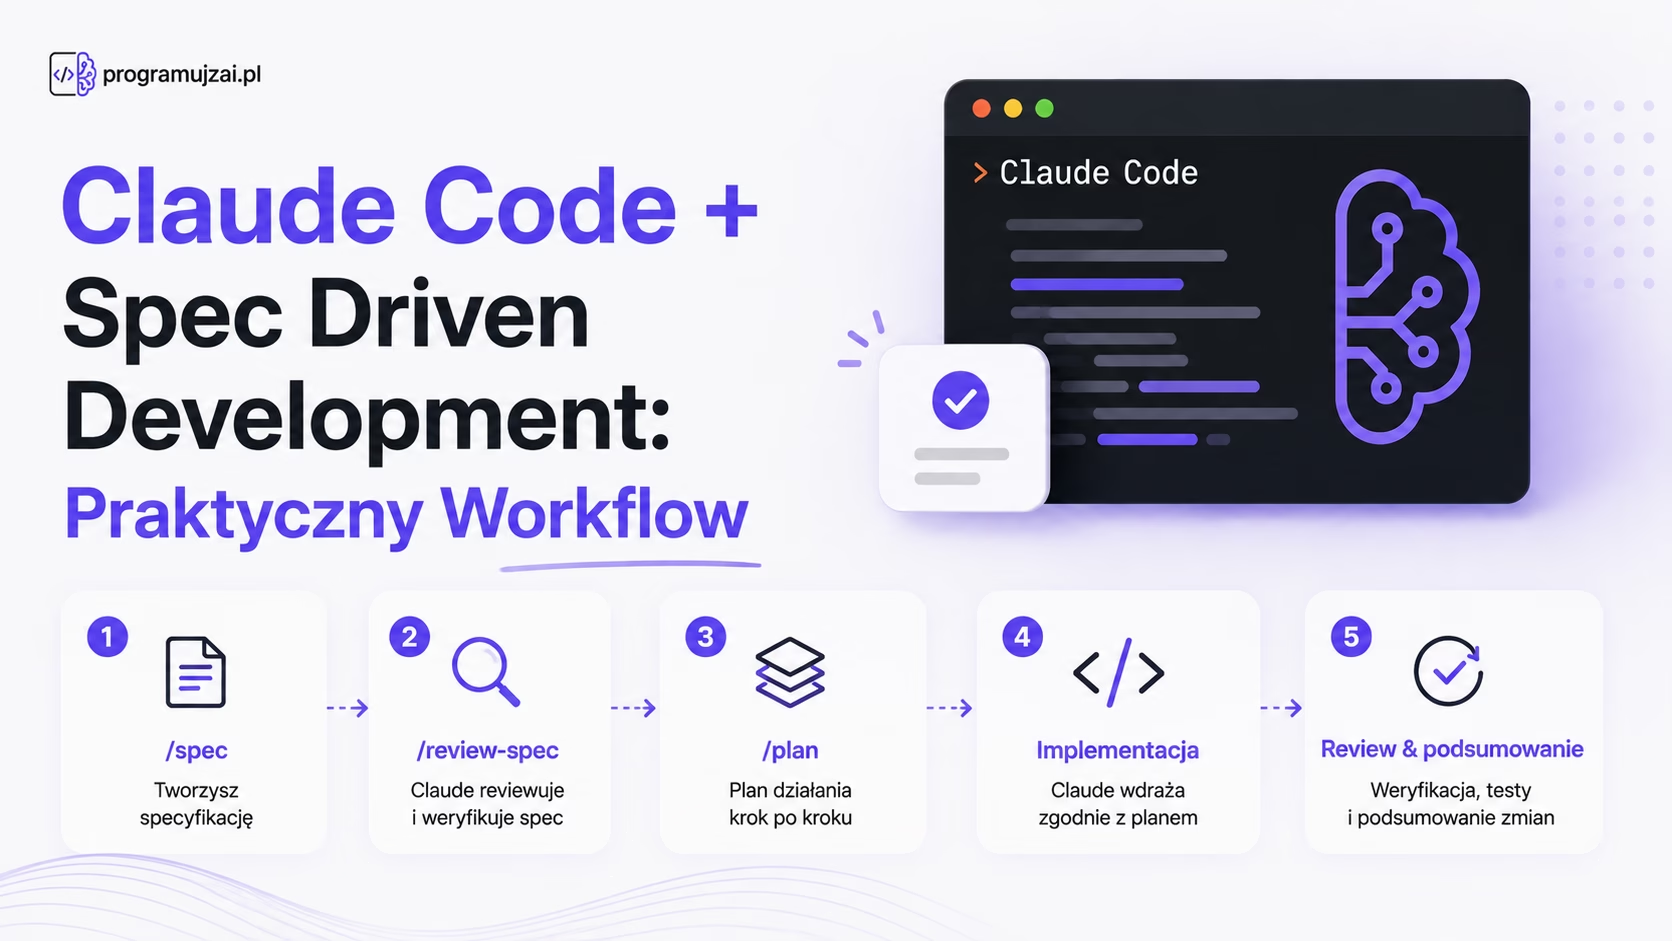
- Workflow iteracyjny: specyfikacja → plan → implementacja → weryfikacja względem kryteriów, nie jednorazowy prompt „zrób to”.
- Ten workflow jest niezależny od stosu technologicznego — działa tak samo dla backendu, frontendu, skryptów czy automatyzacji.
Spis treści:
- Dlaczego sam prompting zawodzi w większych zadaniach
- Jak napisać specyfikację przed pierwszym promptem
- Jak zbudować CLAUDE.md pod spec driven development
- Jak ustrukturyzować pliki kontekstowe, żeby ograniczyć improwizację
- Workflow krok po kroku: od specyfikacji do gotowego kodu
- Najczęstsze błędy przy wdrażaniu SDD z Claude Code
- Jak wdrożyć to w praktyce
- FAQ
- Podsumowanie
Sam prompting zawodzi, gdy zadanie ma więcej niż jedno dorozumiane założenie
Prosty prompt działa dobrze dla zadań jednowymiarowych — napisz funkcję, popraw błąd, wygeneruj test. Problem pojawia się, gdy zadanie ma kilka współzależnych decyzji projektowych: jak nazwać strukturę danych, gdzie umieścić walidację, jak obsłużyć błędy, jakie są granice odpowiedzialności modułu. Bez specyfikacji Claude Code musi podjąć te decyzje samodzielnie, a każda z nich to potencjalna rozbieżność z tym, co faktycznie miałeś na myśli.
Ta rozbieżność kumuluje się. Jedna błędna decyzja architektoniczna w pierwszym kroku prowadzi do kolejnych, spójnych z nią, ale niezgodnych z Twoim zamiarem. Efekt: kod, który „działa”, ale trzeba go przepisać, bo poszedł w złą stronę. Spec driven development eliminuje ten problem, bo decyzje projektowe zapadają przed promptem, a nie podczas generowania kodu.
Warto też odróżnić dwa źródła improwizacji: brak informacji (model nie wie, jak to zrobić, więc zgaduje) i brak ograniczeń (model wie, jak zrobić na kilka sposobów, i wybiera dowolny). Specyfikacja adresuje pierwsze, a CLAUDE.md — drugie, bo działa jak stały zestaw reguł obowiązujących w każdej sesji.
Dobra specyfikacja odpowiada na pytanie „co”, zanim model zdecyduje „jak”
Specyfikacja pod Claude Code nie musi być dokumentem na kilka stron — w większości zadań wystarczy plik .md na kilkanaście-kilkadziesiąt linii, o ile zawiera cztery elementy: cel, kontekst, ograniczenia i kryteria akceptacji. Poniżej minimalny szkielet, którego używam do pojedynczego zadania:
- Cel — jedno zdanie opisujące efekt końcowy z perspektywy użytkownika lub systemu, nie implementacji.
- Kontekst — co już istnieje w projekcie i z czym nowy kod musi współgrać (istniejące moduły, konwencje nazewnictwa, zależności).
- Ograniczenia — czego model nie może zrobić: których bibliotek nie wolno dodawać, jakich wzorców unikać, jakie limity wydajnościowe obowiązują.
- Kryteria akceptacji — lista warunków w formie sprawdzalnej, najlepiej jako konkretne przypadki testowe lub scenariusze „dane wejściowe → oczekiwany wynik”.
Kluczowa zasada: kryteria akceptacji piszesz tak, żeby dało się je zweryfikować bez czytania w myślach autora. Zamiast „obsłuż błędy poprawnie” napisz „przy nieprawidłowym formacie danych wejściowych funkcja zwraca błąd z kodem 422 i komunikatem opisującym pole, które zawiodło”. Im bardziej konkretne kryterium, tym mniejsze pole do interpretacji dla modelu — a to właśnie interpretacja jest źródłem improwizacji.
W praktyce wystarczy prosty szkielet pliku .md, który wypełniasz przed każdym zadaniem:
# Cel
Jednym zdaniem: co ma powstać i po co.

# Kontekst
- Istniejące moduły/pliki, z którymi nowy kod musi współgrać
- Konwencje, które już obowiązują w tej części projektu

# Ograniczenia
- Czego nie wolno dodawać (biblioteki, zależności, wzorce)
- Limity wydajnościowe lub bezpieczeństwa, jeśli dotyczą

# Kryteria akceptacji
- [ ] Dane wejściowe X -> oczekiwany wynik Y
- [ ] Przypadek błędny X -> oczekiwane zachowanie Y
- [ ] Warunek brzegowy X -> oczekiwane zachowanie Y
Ten sam szablon kopiujesz do każdego nowego zadania i wypełniasz treścią specyficzną dla niego. Zajmuje to kilka minut, ale eliminuje najdroższy scenariusz: sytuację, w której Claude Code napisze poprawnie działający kod, który realizuje inny zamysł niż ten, który miałeś w głowie.
CLAUDE.md działa jak specyfikacja projektu, nie pojedynczego zadania
Jeśli specyfikacja opisuje jedno zadanie, to CLAUDE.md opisuje reguły obowiązujące we wszystkich zadaniach w danym repozytorium. To plik, który Claude Code wczytuje automatycznie na starcie sesji, więc wszystko, co w nim umieścisz, działa jak stały kontekst — nie musisz tego powtarzać w każdym prompcie.
Dobrze zbudowany CLAUDE.md pod spec driven development zawiera zwykle:
- Architekturę na wysokim poziomie — z jakich warstw/modułów składa się projekt i jakie są między nimi granice odpowiedzialności.
- Konwencje kodowania — nazewnictwo, styl organizacji plików, sposób obsługi błędów obowiązujący w całym projekcie.
- Zasady pracy ze specyfikacją — jawne polecenie, żeby model przed implementacją potwierdził zrozumienie specyfikacji i zapytał o brakujące informacje zamiast zakładać odpowiedź.
- Listę rzeczy zabronionych — np. brak dodawania nowych zależności bez zgody, brak modyfikacji plików konfiguracyjnych poza zakresem zadania.
- Odniesienie do procesu — informację, że każde zadanie zaczyna się od pliku specyfikacji w określonej lokalizacji (np. katalog
specs/), a nie od promptu ad hoc.
Różnica między projektem z dobrym CLAUDE.md a projektem bez niego jest najbardziej widoczna po kilkunastu sesjach — bez stałego kontekstu model za każdym razem „odkrywa” konwencje na nowo i bywa niespójny sam ze sobą między zadaniami.
Struktura plików kontekstowych ogranicza pole do domysłów, nie objętość dokumentacji
Częstym błędem jest traktowanie plików kontekstowych jak dokumentacji ogólnej — im więcej, tym lepiej. W praktyce działa odwrotnie: nadmiar informacji rozmywa istotne ograniczenia równie skutecznie jak ich brak, bo model musi wybrać, co jest ważne. Skuteczniejsza jest struktura warstwowa:
- CLAUDE.md — reguły globalne, krótkie, rzadko zmieniane.
- specs/nazwa-zadania.md — specyfikacja pojedynczego zadania, żyje tylko na czas jego realizacji.
- docs/decyzje-architektoniczne.md (opcjonalnie) — decyzje, które nie zmieniają się z zadania na zadanie, ale są zbyt szczegółowe, żeby trzymać je w
CLAUDE.md.
Taki podział ma jedną praktyczną zaletę: kiedy zadanie się kończy, usuwasz lub archiwizujesz plik specyfikacji, a globalny kontekst w CLAUDE.md pozostaje czysty. Model nie musi filtrować nieaktualnych informacji o zamkniętych zadaniach, co bezpośrednio zmniejsza ryzyko, że odwoła się do założeń, które już nie obowiązują.
| Element | Workflow bez specyfikacji | Workflow ze spec driven development |
|---|---|---|
| Punkt startowy | Pojedynczy prompt opisujący cel | Plik specyfikacji z celem, kontekstem, ograniczeniami i kryteriami |
| Decyzje projektowe | Podejmowane przez model w trakcie generowania | Podjęte przed promptem, model je realizuje |
| Weryfikacja wyniku | Subiektywna ocena „czy to wygląda dobrze” | Sprawdzalne kryteria akceptacji zdefiniowane wcześniej |
| Spójność między sesjami | Zależna od pamięci operatora, nie modelu | Utrzymana przez CLAUDE.md jako stały kontekst |
| Liczba iteracji do akceptacji | Zwykle wyższa, bo poprawki dotyczą założeń | Zwykle niższa, bo założenia ustalono wcześniej |
Pełny cykl zadania ma cztery fazy, a implementacja jest dopiero trzecią z nich
Konkretny workflow, który stosuję do zadań o średniej i wyższej złożoności, wygląda tak:
- Faza specyfikacji — piszę plik
specs/nazwa-zadania.mdz celem, kontekstem, ograniczeniami i kryteriami akceptacji, zanim otworzę Claude Code. - Faza planu — proszę Claude Code o przedstawienie planu implementacji na podstawie specyfikacji, bez pisania kodu. To krok, w którym najtaniej wyłapać nieporozumienie — poprawka planu kosztuje sekundy, poprawka gotowego kodu kosztuje minuty lub godziny.
- Faza implementacji — dopiero po akceptacji planu proszę o właściwy kod, sekcja po sekcji, jeśli zadanie jest większe niż pojedynczy plik.
- Faza weryfikacji — sprawdzam wynik względem kryteriów akceptacji zapisanych w specyfikacji, nie względem ogólnego wrażenia „czy działa”.
Ten podział rozwiązuje konkretny problem spec driven development bez planu: sama specyfikacja nie gwarantuje, że model dobrze ją zinterpretował. Krok planu działa jak punkt kontrolny — pozwala złapać rozbieżność interpretacji, zanim wygeneruje się kod na jej podstawie.
Najczęstsze błędy pojawiają się wtedy, gdy specyfikacja opisuje implementację zamiast celu
Pierwszy błąd to pisanie specyfikacji na poziomie kodu zamiast na poziomie zamierzonego efektu — zamiast opisać, co system ma robić, autor od razu narzuca konkretną implementację („użyj pętli for i tablicy pomocniczej”). To odbiera modelowi możliwość zaproponowania lepszego rozwiązania i sprowadza specyfikację do roli dyktowania kodu linijka po linijce, co jest wolniejsze niż napisanie go samodzielnie.
Drugi błąd to kryteria akceptacji sformułowane jako odczucia, nie fakty — „kod ma być czytelny” albo „rozwiązanie powinno być eleganckie” nie da się zweryfikować, więc model i tak musi zgadywać, o co dokładnie chodzi. Kryterium powinno dać się sprawdzić jednoznacznie, najlepiej przez uruchomienie konkretnego przypadku testowego.
Trzeci błąd to traktowanie CLAUDE.md jako dokumentu, który piszesz raz i zapominasz. W praktyce plik ten powinien rosnąć po każdym zadaniu, które ujawniło lukę w regułach — jeśli model podjął decyzję, z którą się nie zgadzasz, to sygnał, żeby dodać odpowiednią regułę do CLAUDE.md, zamiast poprawiać to ręcznie za każdym razem od nowa.
Czwarty błąd to pomijanie fazy planu przy zadaniach, które wydają się proste. Właśnie te zadania najczęściej okazują się mieć ukryte założenie, którego nie zapisałeś w specyfikacji — a krótki plan przed implementacją kosztuje dosłownie kilkadziesiąt sekund w porównaniu z poprawianiem gotowego kodu.
Jak wdrożyć to w praktyce
- Utwórz katalog
specs/w repozytorium — to miejsce na pliki specyfikacji poszczególnych zadań, oddzielone od stałego kontekstu projektu. - Napisz pierwszy CLAUDE.md z minimalnym zestawem reguł — architektura, konwencje, zasada „zapytaj, jeśli specyfikacja jest niejednoznaczna”. Nie musi być kompletny od razu, rozbudowujesz go po każdym zadaniu, które ujawniło brakującą regułę.
- Przed każdym nowym zadaniem napisz specyfikację, zanim otworzysz Claude Code — nawet jeśli zajmie to pięć minut, oszczędzasz czas na iteracjach implementacyjnych.
- Wymuś fazę planu przed implementacją — jawnie poproś o plan i zaakceptuj go, zanim padnie prośba o kod.
- Po zakończeniu zadania zaktualizuj CLAUDE.md, jeśli ujawniło nową regułę — spec driven development jest procesem iteracyjnym również na poziomie samego kontekstu projektu, nie tylko pojedynczych zadań.
Ten sam workflow sprawdza się niezależnie od tego, czy pracujesz nad pojedynczym skryptem, czy większym modułem — zmienia się tylko szczegółowość specyfikacji, nie sama struktura procesu.
FAQ — najczęstsze pytania o Claude Code i spec driven development
Czy spec driven development ma sens przy małych zadaniach?
Przy zadaniach jednowymiarowych — pojedyncza funkcja, prosta poprawka — pełna specyfikacja bywa zbędna i zwykły prompt wystarcza. Próg opłacalności pojawia się tam, gdzie zadanie wymaga więcej niż jednej decyzji projektowej: wtedy nawet krótka, kilkulinijkowa specyfikacja zwraca się w postaci mniejszej liczby iteracji poprawkowych.
Jak duży powinien być plik CLAUDE.md?
Krótszy niż intuicja podpowiada. Celem jest zestaw reguł, które model faktycznie uwzględni, a nie kompletna dokumentacja projektu — nadmiar treści rozmywa istotne ograniczenia równie skutecznie jak ich brak. W praktyce kilkadziesiąt-kilkaset linii skupionych na architekturze, konwencjach i zasadach pracy ze specyfikacją wystarcza w większości projektów.
Czy trzeba pisać specyfikację w osobnym pliku, czy wystarczy dłuższy prompt?
Osobny plik ma dwie przewagi nad rozbudowanym promptem: zostaje w repozytorium jako dokumentacja decyzji projektowej i można się do niego odwołać w kolejnej sesji, a Claude Code może go wczytać jako część kontekstu zamiast polegać na Twojej pamięci tego, co dokładnie napisałeś w prompcie tydzień wcześniej.
Co zrobić, gdy model mimo specyfikacji nadal improwizuje?
Najczęstsza przyczyna to pominięcie fazy planu — jeśli od razu prosisz o kod, model interpretuje niejasności po swojemu zamiast je zgłosić. Dodanie jawnego kroku „przedstaw plan, zanim napiszesz kod” oraz zasady w CLAUDE.md, żeby model pytał o brakujące informacje zamiast zakładać odpowiedź, w większości przypadków eliminuje ten problem.
Czy specyfikacje w tym workflow sprawdzają się w zespole, czy tylko przy pracy solo?
Sprawdzają się lepiej w zespole niż przy pracy solo, bo plik specyfikacji staje się wspólnym punktem odniesienia — zamiast tłumaczyć koledze ustnie, co dokładnie miał zrobić dany prompt, wskazujesz plik w specs/. To samo dotyczy code review: reviewer sprawdza, czy implementacja spełnia kryteria akceptacji zapisane w specyfikacji, a nie zgaduje intencję autora na podstawie samego kodu.
Podsumowanie
Claude Code spec driven development w praktyce sprowadza się do jednej zmiany nawyku: decyzje projektowe zapadają przed promptem, nie w jego trakcie. Specyfikacja zadania odpowiada na pytanie „co”, CLAUDE.md utrzymuje stałe reguły projektu, a faza planu przed implementacją wyłapuje nieporozumienia, zanim staną się kodem do poprawki. To podejście nie wymaga zmiany stosu technologicznego ani narzędzi — wymaga tylko konsekwencji w pisaniu specyfikacji, zanim otworzysz Claude Code.
Jeśli chcesz zobaczyć ten workflow na żywym przykładzie, obejrzyj rozbiór konkretnego zadania na moim kanale YouTube, a dodatkowy bonus z gotowym szablonem CLAUDE.md znajdziesz na standev.it/ai-workflow-bonus. Więcej o samej metodologii przeczytasz w artykule o przewadze Spec Driven Development, a jeśli dopiero zaczynasz z tym narzędziem, zajrzyj do przeglądu komend Claude Code.
Dodaj komentarz