O autorze
Jakub Stankowski – programista .NET i Angular od 2018 roku. Pracował nad projektami frontendowymi, backendowymi i fullstackowymi, przestrzegając zasad czystego kodu, DRY i stosując CQRS. Ma również doświadczenie jako trener programowania.
Od 2023 roku intensywnie pracuje z Claude AI oraz metodą Spec-Driven Development (SDD) – produkcyjnym workflow do pracy z AI opartym na zasadzie: najpierw specyfikacja, potem implementacja. Na ProgramujZAI.pl dzieli się praktyczną wiedzą o tym, jak programować z AI bez chaosu w kodzie.
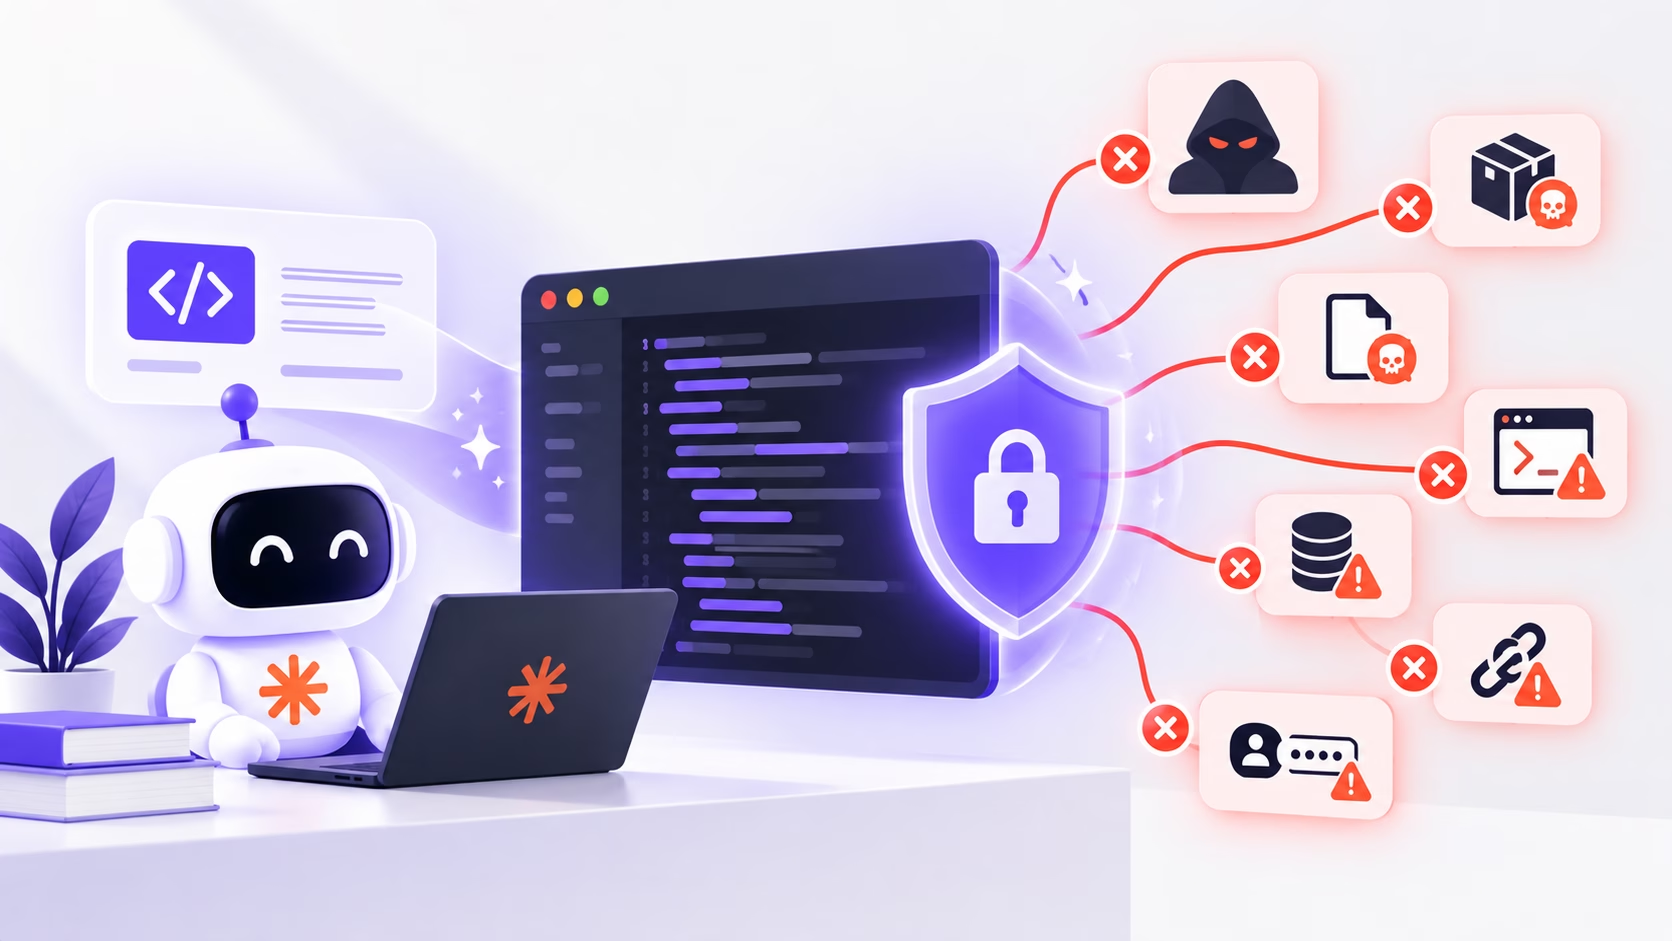
Kod z AI jest tak bezpieczny, jak środowisko, w którym pracuje agent. Największe ryzyko nie leży dziś w składni, tylko w tym, co agent może zrobić sam: zainstalować zmyślony pakiet, przeczytać plik .env albo wykonać polecenie ukryte w pliku lub serwerze MCP. Chronią przed tym cztery warstwy: wąskie uprawnienia, hooki blokujące groźne komendy, sekcja bezpieczeństwa w specyfikacji i checklista do review. Poniżej 7 zagrożeń, które widzę w codziennej pracy z Claude Code, i ochrona dla każdego z nich.
Najważniejsze informacje
- Agent zmienia model zagrożeń – liczy się to, co może zrobić bez Twojej zgody.
- Slopsquatting – atakujący rejestrują nazwy pakietów, które modele zmyślają.
- Prompt injection przychodzi przez pliki, strony i opisy narzędzi MCP.
- Reguły deny i hooki PreToolUse blokują groźne akcje, zanim się wykonają.
- Specyfikacja z sekcją bezpieczeństwa mówi agentowi, czego mu nie wolno.
Agent AI zmienia model zagrożeń, nie tylko sposób pisania kodu
Czat z LLM zwracał tekst, który kopiowałeś ręcznie. Agent sam czyta repozytorium, uruchamia komendy i instaluje zależności. Dlatego pytanie „czy kod z AI jest bezpieczny” to dziś za mało. Trzeba zapytać, co agent zrobi bez Twojej zgody.
Sam kod też nie jest wolny od błędów. Raport Veracode z 2025 roku pokazał, że w około 45% zadań modele wybierały implementację z luką bezpieczeństwa. OWASP nadal obowiązuje, ale dochodzą zagrożenia typowe dla agentów.
7 zagrożeń, które realnie pojawiają się przy pracy z agentem
1. Zmyślone pakiety (slopsquatting) trafiają prosto do zależności
Model podaje nazwę biblioteki, która nie istnieje. Atakujący rejestrują takie nazwy w npm czy PyPI i wrzucają tam złośliwy kod. Badanie zaprezentowane na USENIX Security 2025 wykazało, że około 20% polecanych przez modele pakietów było zmyślonych. Wiele z tych nazw powtarzało się w kolejnych zapytaniach.
Ochrona: instalacja zależności zawsze wymaga Twojej zgody. W specyfikacji wpisz listę dozwolonych bibliotek.
2. Sekrety wyciekają do kontekstu agenta
Agent czyta .env, logi i pliki konfiguracyjne. Klucz API, który raz trafi do kontekstu, może wylądować w kodzie, commicie albo w logu.
Ochrona: reguły deny na odczyt plików z sekretami i skaner sekretów (np. gitleaks) w pre-commit.
3. Prompt injection przychodzi przez zwykłe pliki
Ukryta instrukcja w README, komentarzu w issue albo na stronie dokumentacji działa jak polecenie. Model nie odróżnia pewnie danych od instrukcji.
Ochrona: nie dawaj agentowi jednocześnie niezaufanych treści, dostępu do sieci i sekretów. Diffy z takich zadań czytaj szczególnie uważnie.
4. Serwery MCP mogą przemycić instrukcje w opisach narzędzi
Opisy narzędzi MCP trafiają do kontekstu modelu. Invariant Labs opisało w 2025 roku atak „tool poisoning”: złośliwy serwer ukrywa w opisie polecenie odczytu i wysłania plików. To najgroźniejsza forma, jaką przybiera prompt injection w agentach AI.
Ochrona: tylko serwery z zaufanych źródeł, przypięte wersje i tokeny o minimalnym zakresie. Szczegóły znajdziesz w artykule o MCP.
5. Zbyt szerokie uprawnienia zamieniają pomyłkę w awarię
Tryb --dangerously-skip-permissions jest wygodny. Wystarczy jednak jedno złe polecenie, żeby skończyło się na rm -rf albo git push --force.
Ochrona: allow tylko dla bezpiecznych komend, ask dla instalacji i push, hook blokujący groźne polecenia. Tryb bez pytań uruchamiaj wyłącznie w kontenerze.
6. Model kopiuje podatne wzorce z danych treningowych
SQL sklejany ze stringów, MD5 do haseł, wyłączona walidacja certyfikatów, CORS z gwiazdką. Model powiela to, co popularne, a nie to, co bezpieczne. Proponuje też stare wersje bibliotek ze znanymi CVE.
Ochrona: zakazane wzorce w specyfikacji, audyt zależności w CI i testy bezpieczeństwa.
7. Zmęczenie review sprawia, że akceptujesz kod bez czytania
Po dziesiątym poprawnym diffie przestajesz czytać jedenasty. To ludzki błąd, ale agent go wzmacnia, bo generuje dużo i szybko.
Ochrona: małe zadania, stała checklista i code review z AI jako drugi filtr, nie zamiennik.
Każde zagrożenie ma konkretną warstwę ochrony
| Zagrożenie | Uprawnienia / hook | Specyfikacja | Review |
|---|---|---|---|
| Slopsquatting | ask dla install | lista dozwolonych bibliotek | sprawdź nowe zależności |
| Wyciek sekretów | deny na .env | zakaz hardcodowania | skaner sekretów |
| Injection przez pliki | brak sieci w zadaniu | źródła zaufane | uważny diff |
| Injection przez MCP | minimalne tokeny | lista serwerów | audyt konfiguracji |
| Szerokie uprawnienia | hook PreToolUse | zakres zadania | log komend |
| Podatne wzorce | audyt w CI | zakazane wzorce | checklista |
| Zmęczenie review | – | małe zadania | drugi filtr AI |
Jak wdrożyć to w praktyce
- Ustaw reguły w .claude/settings.json.
{ "permissions": { "deny": ["Read(./.env)", "Read(./.env.*)", "Read(./secrets/**)"], "ask": ["Bash(npm install:*)", "Bash(pip install:*)", "Bash(git push:*)"] }, "hooks": { "PreToolUse": [{ "matcher": "Bash", "hooks": [{ "type": "command", "command": ".claude/hooks/block.sh" }] }] } } - Dodaj hook blokujący. Kod wyjścia 2 zatrzymuje komendę i przekazuje powód agentowi.
cmd=$(jq -r '.tool_input.command') if echo "$cmd" | grep -qE 'rm -rf|--force|--no-verify'; then echo "Zablokowane przez hook bezpieczeństwa" >&2; exit 2 fi - Dopisz sekcję bezpieczeństwa do specyfikacji: dozwolone biblioteki, zakazane wzorce, sposób obsługi sekretów i walidacji wejścia. Wzór znajdziesz w artykule jak napisać specyfikację dla AI.
- Używaj stałej checklisty review: nowe zależności, sekrety w diffie, zapytania do bazy, walidacja wejścia, zmiany uprawnień.
- Dodaj testy bezpieczeństwa zgodnie z zasadami z artykułu o testowaniu kodu z AI.
Jeśli agent mimo to robi rzeczy, których nie chcesz, sprawdź najczęstsze błędy w Claude Code.
FAQ: bezpieczeństwo kodu AI
Czy kod z AI jest bezpieczny?
Nie z definicji. Jest tak bezpieczny, jak specyfikacja, uprawnienia agenta i review. Bez tych warstw część wygenerowanego kodu zawiera znane podatności.
Co to jest slopsquatting?
To atak, w którym ktoś rejestruje nazwę pakietu zmyśloną przez model AI. Gdy agent ją zainstaluje, w projekcie ląduje złośliwy kod.
Jak chronić się przed prompt injection w agentach AI?
Ogranicz to, co agent może zrobić po przeczytaniu niezaufanej treści. Odetnij sieć i sekrety w takich zadaniach, a serwery MCP instaluj tylko z zaufanych źródeł.
Czy można używać –dangerously-skip-permissions?
Tak, ale tylko w izolowanym kontenerze bez dostępu do sekretów i produkcji. Na własnej maszynie to proszenie się o kłopoty.
Bezpieczeństwo kodu AI to nie jedna wtyczka, tylko kilka prostych warstw ustawionych raz na projekt. Pokazuję je na żywo na moim kanale YouTube. Gotową konfigurację i szablony znajdziesz w AI Workflow Bonus na standev.it.
Dodaj komentarz